Ten sam kontrahent zapisany w trzech programach może mieć trzy różne nazwy, dwa adresy i kilka numerów identyfikacyjnych. W systemie księgowym widnieje pod pełną nazwą spółki, w CRM pod nazwą handlową, a w programie magazynowym jako oddział. Po migracji takie rekordy często stają się osobnymi kartotekami, choć dotyczą tego samego podmiotu. Skutek? Rozproszone saldo należności, niepełna historia zakupów, powielone limity kredytowe i błędy przy wystawianiu dokumentów. Wykrywanie ukrytych duplikatów kontrahentów wymaga czegoś więcej niż porównania nazw i usunięcia powtarzających się wierszy. Trzeba ustalić tożsamość podmiotu, zachować relacje biznesowe i kontrolować każdy etap łączenia danych.
Skąd biorą się ukryte duplikaty kontrahentów i jak odróżnić je od osobnych podmiotów?
Największym problemem przy konsolidacji baz jest to, że poszczególne programy inaczej rozumieją pojęcie kontrahenta. System księgowy koncentruje się na danych podatkowych i rozrachunkach. CRM przechowuje informacje o kontaktach, opiekunach handlowych i historii sprzedaży. Program magazynowy potrzebuje przede wszystkim lokalizacji dostaw. Każdy może więc posiadać osobny rekord opisujący tę samą firmę, ale z innym zestawem informacji.
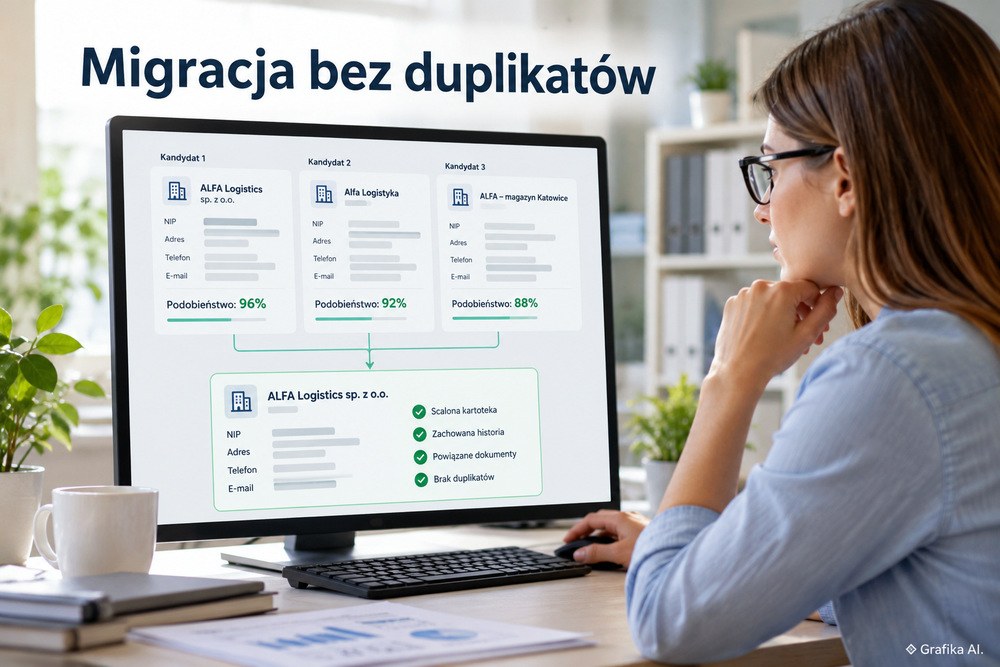
Przykład hipotetyczny: firma korzysta z trzech systemów. W programie księgowym kontrahent występuje jako „ALFA Logistics sp. z o.o.”, w CRM jako „Alfa Logistyka”, natomiast w aplikacji magazynowej jako „ALFA – magazyn Katowice”. Wszystkie rekordy mają ten sam poprawny NIP, lecz różne adresy i numery telefonów. Najprawdopodobniej dotyczą jednego podmiotu prawnego, ale nie oznacza to, że należy bezwarunkowo usunąć dwa z nich. Magazyn może być odrębną lokalizacją dostawy, a CRM przechowywać kontakty przypisane do konkretnego działu.
Przed deduplikacją trzeba zatem rozdzielić cztery poziomy danych:
- Podmiot prawny – firma lub osoba będąca stroną umowy, faktury albo rozrachunku.
- Oddział lub lokalizacja – magazyn, sklep, zakład produkcyjny lub punkt dostawy należący do określonego podmiotu.
- Osoba kontaktowa – pracownik, przedstawiciel lub osoba odpowiedzialna za zamówienia.
- Rola biznesowa – klient, dostawca, odbiorca faktury, płatnik lub inna funkcja realizowana przez kontrahenta.
To rozróżnienie ma konkretne konsekwencje. Jeżeli jedna spółka posiada pięć magazynów, nowy system może potrzebować jednej kartoteki podmiotu i pięciu powiązanych lokalizacji. Utworzenie pięciu niezależnych kontrahentów utrudni analizę obrotów. Z kolei połączenie wszystkich adresów w jeden spowoduje pomyłki przy realizacji dostaw.
Najważniejszym punktem wyjścia jest identyfikacja podatkowa. Polski NIP składa się z 10 cyfr. Przed porównaniem numerów należy usunąć separatory, sprawdzić długość oraz sumę kontrolną, a następnie zweryfikować identyfikator w systemie Krajowej Administracji Skarbowej. Usługa sprawdzania statusu NIP pozwala ustalić, czy numer jest poprawny i istnieje w systemie KAS.
Trzeba jednak odróżnić trzy rzeczy: poprawność matematyczną numeru, jego status w rejestrze oraz tożsamość prawną podmiotu. Poprawna suma kontrolna nie dowodzi jeszcze, że rekord zawiera prawdziwe dane przedsiębiorcy. Także zgodność NIP nie rozstrzyga automatycznie, czy wszystkie informacje dotyczą jednej kartoteki operacyjnej. Ten sam przedsiębiorca może działać w kilku lokalizacjach, a jego dane handlowe mogą różnić się zależnie od oddziału.
Przy kontrahentach zagranicznych identyfikator należy porównywać razem z kodem kraju i rodzajem numeru. Sam ciąg cyfr nie wystarcza. Numer VAT UE można sprawdzić w unijnym systemie VIES, ale wynik kontroli dotyczy identyfikacji na potrzeby transakcji VAT w Unii Europejskiej. Nie jest uniwersalnym potwierdzeniem ciągłości prawnej przedsiębiorstwa ani pełnym rejestrem wszystkich firm.
Podobnej ostrożności wymagają nazwy i adresy. Spółka może zmienić nazwę bez zmiany swojej tożsamości prawnej, przenieść siedzibę albo posługiwać się nazwą skróconą. Z drugiej strony dwie niezależne spółki mogą mieć bardzo podobne nazwy i ten sam adres biura. W takich przypadkach należy sprawdzić odpowiednie dane w KRS, CEIDG lub REGON, a przy przekształceniach również dokumenty określające ciągłość prawną.
Osobnym przypadkiem są osoby fizyczne bez NIP, np. klienci dokonujący zakupów prywatnych. Nie można wymagać od nich identyfikatora podatkowego tylko po to, aby uprościć migrację. Porównanie imienia, nazwiska, adresu, telefonu czy e-maila pozwala wskazać potencjalne duplikaty, lecz nie potwierdza tożsamości. Dwie osoby mogą mieszkać razem, korzystać z jednego numeru telefonu lub mieć identyczne imię i nazwisko.
Kiedy łączenie ma sens? Gdy zweryfikowane identyfikatory i historia podmiotu potwierdzają wspólną tożsamość, a różnice dotyczą jedynie nazw, adresów kontaktowych lub lokalizacji. Kiedy jest ryzykowne? Gdy występują sprzeczne numery identyfikacyjne, niejasne przekształcenia, odrębne podmioty należące do jednej grupy kapitałowej albo brak wystarczających danych do rozstrzygnięcia. Wtedy rekordy należy pozostawić oddzielnie do wyjaśnienia.
Najdroższym błędem na tym etapie jest potraktowanie podobieństwa nazw jako dowodu, że kontrahenci są tym samym przedsiębiorstwem. Po takim scaleniu mogą zostać pomieszane faktury, zamówienia i należności różnych podmiotów. Odtworzenie prawidłowych relacji bywa znacznie trudniejsze niż pierwotne uporządkowanie kartotek.
Jak wykrywać duplikaty przed migracją: normalizacja, fuzzy matching i weryfikacja identyfikatorów
Oczyszczanie danych najlepiej przeprowadzać poza produkcyjną bazą docelową, w osobnej warstwie stagingowej. Trafiają do niej kopie rekordów ze wszystkich programów. Na tym etapie nie usuwa się jeszcze kontrahentów ani nie nadpisuje ich oryginalnych danych. Najpierw trzeba zachować wartości źródłowe, identyfikatory i informacje o pochodzeniu każdego rekordu.
Minimalny zestaw pól przydatnych podczas analizy obejmuje identyfikator systemu źródłowego, wewnętrzny numer kontrahenta, nazwę, kraj, rodzaj i wartość identyfikatora podatkowego, REGON lub KRS (jeśli występują), adres, dane kontaktowe oraz status kartoteki. W przypadku migracji dokumentów potrzebne są również informacje o powiązaniach kontrahenta z fakturami, zamówieniami i rozrachunkami.
Pierwszą operacją jest normalizacja danych, czyli przygotowanie ich do porównania. Nie powinna ona jednak oznaczać bezpowrotnej modyfikacji wartości źródłowych.
- NIP: usunięcie spacji i myślników, kontrola długości oraz poprawności numeru.
- Nazwy firm: ujednolicenie wielkości liter i zbędnych odstępów, a także przygotowanie pomocniczych wariantów skrótów form prawnych.
- Adresy: rozdzielenie ulicy, numeru budynku, lokalu, kodu pocztowego, miejscowości i kraju.
- Telefony: normalizacja zapisu wraz z uwzględnieniem numeru kierunkowego kraju.
- Adresy e-mail: usunięcie przypadkowych odstępów i porównywanie odpowiednio przygotowanych wartości bez traktowania wspólnej domeny jako potwierdzenia tożsamości.
Przy normalizacji łatwo przesadzić. Usuwanie wszystkich znaków specjalnych, polskich liter czy członów nazw może zwiększyć liczbę fałszywych dopasowań. Przykładowo usunięcie informacji o formie prawnej ułatwia wyszukiwanie podobnych nazw, lecz nie może służyć jako samodzielna podstawa łączenia spółki z działalnością gospodarczą osoby fizycznej.
Dlatego oryginalna nazwa powinna pozostać nietknięta, a jej uproszczona wersja funkcjonować jako dodatkowe pole porównawcze.
Po normalizacji można rozpocząć właściwe wykrywanie duplikatów. Rozsądna kolejność wygląda następująco:
- 1. Dopasowanie dokładne. Porównanie zweryfikowanych identyfikatorów podatkowych i rejestrowych wraz z krajem oraz typem podmiotu.
- 2. Kontrola konfliktów. Wykrycie rekordów, które mają zgodne nazwy, ale różne identyfikatory, lub ten sam identyfikator i sprzeczne informacje prawne.
- 3. Dopasowanie przybliżone. Wyszukiwanie podobnych nazw i adresów przy użyciu algorytmów fuzzy matching.
- 4. Ocena kandydatów. Skierowanie niejednoznacznych par do ręcznej weryfikacji.
- 5. Zatwierdzenie relacji. Oznaczenie rekordów jako duplikatów tego samego podmiotu, powiązanych oddziałów albo niezależnych kontrahentów.
Fuzzy matching wykorzystuje algorytmy mierzące podobieństwo tekstu, np. odległość Levenshteina czy Jaro-Winklera. Potrafi wykryć zbliżone zapisy, których klasyczne porównanie dokładne nie uzna za zgodne. Przykładowo „Trans-Pol Serwis” i „Transpol Serwis” mogą uzyskać wysoki wynik podobieństwa mimo różnic w pisowni.
Nie oznacza to jednak, że algorytm rozpoznaje tożsamość prawną. Sprawdza podobieństwo danych, a nie rzeczywiste relacje między przedsiębiorstwami.
Przykład hipotetyczny: do warstwy stagingowej trafia 40 000 kartotek z systemów ERP, CRM i programu fakturowego. Po normalizacji i wstępnym porównaniu mechanizm wskazuje 1 800 potencjalnie podobnych par. Zespół projektowy ustala roboczą punktację od 0 do 100:
- 90–100 punktów: kandydaci o wysokim podobieństwie, kierowani do przyspieszonej weryfikacji lub dodatkowych reguł identyfikacyjnych.
- 75–89 punktów: przypadki wymagające szczegółowego sprawdzenia danych rejestrowych i historii kontrahenta.
- Poniżej 75 punktów: rekordy niewłączane do standardowej kolejki, chyba że inne dane wskazują na możliwy duplikat.
Są to wyłącznie przykładowe progi przyjęte na potrzeby scenariusza, a nie parametry zalecane dla każdego projektu. Ich wybór zależy od zastosowanego algorytmu, jakości danych i kosztu pomyłki. Przed wdrożeniem należy ręcznie ocenić próbkę par i sprawdzić dwie miary: precyzję wykrywania, czyli udział rzeczywistych duplikatów wśród wskazanych kandydatów, oraz czułość, czyli udział wykrytych duplikatów wśród wszystkich rzeczywistych duplikatów w ocenianej próbce.
Obniżenie progu podobieństwa zwykle zwiększa liczbę kandydatów, ale również liczbę błędnych wskazań. Podniesienie progu ogranicza pracę ręczną, za to grozi pominięciem części duplikatów. Przy danych finansowych większym zagrożeniem jest błędne połączenie dwóch różnych podmiotów niż pozostawienie dodatkowej kartoteki do późniejszego wyjaśnienia.
Równie ważna jest wydajność. Porównywanie każdego rekordu z każdym daje przy 40 000 rekordów dokładnie 799 980 000 nieuporządkowanych par. Dlatego przy większych zbiorach stosuje się tzw. blocking, czyli wstępne ograniczanie kandydatów według określonych cech, np. kraju, fragmentu nazwy lub kodu pocztowego. Zmniejsza to nakład obliczeń, ale źle skonfigurowane reguły mogą odciąć prawdziwe dopasowania już na początku procesu.
Dobór narzędzia zależy od skali projektu. Dla kilku tysięcy kartotek z kompletnymi identyfikatorami wystarczające mogą być zapytania SQL lub przekształcenia w Microsoft Power Query. Gdy źródeł jest więcej, dane są niespójne, a migracje mają się powtarzać, uzasadnione staje się wykorzystanie narzędzi ETL i rozwiązań do zarządzania jakością danych.
Nie należy również zakładać, że wbudowana funkcja wykrywania duplikatów w docelowym systemie wychwyci wszystkie przypadki. Przykładowo Microsoft Dataverse wykorzystuje reguły wykrywania duplikatów i generowane kody dopasowania, ale ich działanie zależy od konfiguracji oraz rodzaju operacji. Dokumentacja producenta wskazuje również ograniczenia związane z równoczesnym tworzeniem rekordów i konieczność stosowania dodatkowych kontroli.
Kiedy automatyzacja ma sens? Gdy reguły zostały przetestowane na reprezentatywnych danych, a przypadki jednoznaczne można oddzielić od wymagających interpretacji. Nie ma natomiast uzasadnienia dla automatycznego scalania rekordów wyłącznie na podstawie procentowego podobieństwa nazw. Algorytm powinien przede wszystkim przygotować listę decyzji, a nie podejmować wszystkie decyzje za administratora danych.
Jak scalić kartoteki bez utraty faktur, rozrachunków i historii współpracy?
Samo odnalezienie duplikatów nie kończy migracji. Trudniejsza część zaczyna się wtedy, gdy trzeba zachować powiązania pomiędzy starymi identyfikatorami kontrahentów a dokumentami w nowym systemie. Usunięcie powielonej kartoteki bez aktualizacji relacji może pozostawić faktury bez właściwego kontrahenta lub przypisać je do nieodpowiedniego podmiotu.
Podstawą bezpiecznego przeniesienia danych jest tabela mapowania identyfikatorów. Musi umożliwiać odtworzenie pochodzenia każdego rekordu i wskazywać, do jakiej kartoteki został przypisany.
Przykład hipotetyczny: ten sam dostawca figuruje w trzech aplikacjach jako ERP-125, CRM-908 i MAG-443. Po zweryfikowaniu tożsamości zostaje utworzona kartoteka MASTER-62. W tabeli mapowania zapisuje się wszystkie trzy identyfikatory źródłowe wraz z informacją o pochodzeniu. Dzięki temu faktura powiązana wcześniej z ERP-125 trafia do MASTER-62, natomiast historia zamówień z MAG-443 pozostaje dostępna z zachowaniem konkretnego adresu dostawy.
Tabela mapowania powinna zawierać przynajmniej:
- nazwę lub kod systemu źródłowego;
- oryginalny identyfikator kontrahenta;
- identyfikator kartoteki docelowej;
- rodzaj relacji, np. duplikat podmiotu, oddział lub kontakt;
- status decyzji: zatwierdzona, odrzucona lub wymagająca wyjaśnienia;
- datę, osobę zatwierdzającą i uzasadnienie połączenia;
- identyfikator wykonania migracji umożliwiający odtworzenie operacji.
Nie można zakładać, że numer wewnętrzny kontrahenta jest unikalny między systemami. Identyfikator 125 może oznaczać inną firmę w ERP i inną w CRM. Dlatego klucz mapowania musi uwzględniać co najmniej system źródłowy oraz identyfikator rekordu. W środowiskach obejmujących kilka spółek lub baz danych potrzebne bywają dodatkowe oznaczenia jednostki organizacyjnej i instancji systemu.
Następna decyzja dotyczy wyboru master data, czyli nadrzędnych danych kontrahenta. Nie zawsze powinny pochodzić z jednego programu. Nazwę prawną i identyfikatory należy uzgodnić z właściwym rejestrem, natomiast aktualne warunki handlowe mogą wynikać z podpisanej umowy, a adres dostawy z systemu logistycznego.
Dobry model zakłada pierwszeństwo źródeł dla poszczególnych pól, a nie całych aplikacji. W przeciwnym razie przy imporcie łatwo nadpisać ważne informacje.
Załóżmy, że CRM zawiera termin płatności 30 dni, a system księgowy 14 dni. Automatyczne wybranie nowszego wpisu nie rozwiązuje konfliktu. Trzeba sprawdzić, czy istnieje aktualna umowa lub aneks, jakiego zakresu transakcji dotyczy warunek oraz od kiedy obowiązuje. W przeciwnym razie po migracji mogą powstawać błędne terminy wymagalności i nieprawidłowe monity płatnicze.
Podobna zasada dotyczy rachunków bankowych, limitów kredytowych i statusów blokady kontrahenta. Takie pola wymagają osobnych reguł zatwierdzania. Nie powinny być automatycznie nadpisywane informacją z dowolnego systemu tylko dlatego, że zawiera ona późniejszą datę modyfikacji.
Przed przełączeniem produkcyjnym konieczny jest test migracji. Powinien on obejmować nie tylko liczbę kartotek, ale też integralność dokumentów i powiązań. W praktyce trzeba sprawdzić:
- Kompletność rekordów: czy każdy kontrahent ze źródeł otrzymał przypisanie, został świadomie wykluczony albo trafił do listy wyjątków.
- Spójność dokumentów: czy faktury, korekty, zamówienia i rozrachunki wskazują właściwe podmioty.
- Zgodność wartości: czy sumy dokumentów i salda w uzgodnionym zakresie migracji odpowiadają danym źródłowym.
- Weryfikację relacji: czy nie zniknęły oddziały, adresy dostaw, osoby kontaktowe i role kontrahentów.
- Powtarzalność importu: czy ponowne wykonanie procedury nie powoduje tworzenia kolejnych duplikatów.
- Ślad audytu: czy można ustalić, kto, kiedy i na jakiej podstawie zatwierdził scalenie.
- Procedurę wycofania: czy przetestowano przywrócenie danych i zależności po nieudanym imporcie.
Sam spadek liczby kartotek po migracji nie świadczy o sukcesie. Jeżeli z 40 000 rekordów powstało 35 000 kartotek, trzeba potrafić wyjaśnić każdą kategorię różnic: scalone duplikaty, wykluczone rekordy, przeniesione oddziały i pozostałe wyjątki. Szczególnie podejrzane są dokumenty bez powiązanego kontrahenta oraz przypadki, w których jedna faktura została przypisana do kilku różnych podmiotów.
Oddzielnego przygotowania wymaga rollback, czyli możliwość wycofania migracji. Kopia zapasowa bazy to za mało. Trzeba zachować również wersje skryptów, mapowania identyfikatorów i stan integracji. Jeżeli po uruchomieniu nowego systemu użytkownicy rozpoczną wystawianie faktur, przywrócenie wcześniejszej kopii może oznaczać utratę nowych operacji. Dlatego należy ustalić moment zamrożenia zapisów, warunki przełączenia i procedurę postępowania z dokumentami powstałymi po migracji.
Istotna pozostaje także zgodność z RODO. Dane kontrahentów będących osobami fizycznymi, przedsiębiorców prowadzących jednoosobową działalność oraz osób kontaktowych mogą być danymi osobowymi. Artykuł 5 RODO określa m.in. zasady prawidłowości, minimalizacji, ograniczenia przechowywania oraz integralności i poufności. Artykuł 32 wymaga stosowania środków bezpieczeństwa odpowiednich do ryzyka.
W projekcie migracyjnym oznacza to konieczność ograniczenia dostępu do danych stagingowych, zabezpieczenia eksportów, ustalenia zasad usuwania kopii roboczych i kontroli uprawnień. Dobrą praktyką jest również wykorzystywanie danych zanonimizowanych lub odpowiednio pseudonimizowanych w testach, gdy pełna identyfikacja osób nie jest potrzebna. Pseudonimizacja nie oznacza jednak, że dane automatycznie przestają podlegać RODO.
Przy wyborze rozwiązania lub wykonawcy migracji należy wymagać konkretnych mechanizmów: zachowania identyfikatorów źródłowych, raportowania konfliktów, kontrolowania decyzji o scalaniu i odtwarzania powiązań dokumentów. Nie należy uznawać samej deklaracji obsługi importu kontrahentów za potwierdzenie tych możliwości. Funkcje muszą zostać sprawdzone w dokumentacji i najlepiej w teście na rzeczywistym modelu danych.
Od czego zacząć? Najpierw wyeksportować kartoteki ze wszystkich systemów wraz z pierwotnymi identyfikatorami. Następnie zweryfikować jakość NIP i oznaczeń krajów, zdefiniować różnicę między podmiotem prawnym a oddziałem oraz zbudować tabelę mapowania. Dopiero po tych działaniach należy uruchomić wykrywanie podobieństw i przygotować próbne scalenie. Najważniejszy błąd do usunięcia w pierwszej kolejności to utożsamianie podobnej nazwy lub wspólnego adresu z tożsamością kontrahenta. Bez jego wyeliminowania nawet technicznie poprawny import może stworzyć bazę, której nie da się bezpiecznie wykorzystać do księgowania i obsługi klientów.
FAQ – najczęstsze pytania o duplikaty kontrahentów podczas migracji
Czy dwóch kontrahentów z tym samym NIP można automatycznie połączyć?
Nie bez dodatkowej kontroli. Należy zweryfikować numer, rodzaj podmiotu i relacje organizacyjne. Jeden przedsiębiorca może posiadać kilka oddziałów, które powinny pozostać oddzielnymi lokalizacjami w nowym systemie.
Jak wykrywać duplikaty kontrahentów bez NIP?
Porównując kilka cech jednocześnie, np. nazwę lub imię i nazwisko, adres, telefon i historię transakcji. Takie dopasowanie powinno wskazywać kandydatów do ręcznej weryfikacji, a nie automatycznie scalać rekordy.
Czy zgodny adres oznacza, że dwie firmy są tym samym podmiotem?
Nie. Pod jednym adresem może działać wiele niezależnych spółek, zwłaszcza w biurowcach i biurach wirtualnych. Adres należy traktować jako informację pomocniczą.
Jaki próg fuzzy matching jest najlepszy?
Nie istnieje uniwersalny próg. Należy przetestować algorytm na ręcznie zweryfikowanej próbce i ocenić liczbę błędnych dopasowań oraz pominiętych duplikatów. Przy dokumentach finansowych trzeba szczególnie ograniczać ryzyko fałszywego scalenia.
Czy po scaleniu można usunąć stare identyfikatory kontrahentów?
Nie należy usuwać informacji potrzebnych do odtworzenia historii migracji. Stare identyfikatory powinny pozostać w tabeli mapowania razem z oznaczeniem systemu źródłowego i identyfikatorem docelowym, przez okres uzasadniony wymaganiami prawnymi i operacyjnymi.
Jak sprawdzić, czy migracja nie uszkodziła historii faktur?
Porównać identyfikatory dokumentów, ich liczbę, wartości i powiązania z kontrahentami przed importem oraz po nim. Dodatkowo zweryfikować salda, korekty, płatności i dokumenty bez przypisanej kartoteki.
Czy warto scalać nieaktywnych kontrahentów?
Tylko wtedy, gdy istnieje uzasadnienie biznesowe lub techniczne. Jeżeli nieaktywne kartoteki są potrzebne wyłącznie do zachowania historii, bezpieczniejszym rozwiązaniem może być pozostawienie ich jako archiwalnych, z właściwym mapowaniem dokumentów.
Czy wbudowany mechanizm wykrywania duplikatów w ERP lub CRM wystarczy?
W prostych migracjach może być wystarczający, jeżeli obsługuje wymagane pola i reguły. Przy wielu źródłach, niepełnych identyfikatorach i skomplikowanych relacjach zwykle potrzebna jest dodatkowa analiza w warstwie stagingowej.
Co zrobić najpierw, jeśli w bazach jest kilkadziesiąt tysięcy kontrahentów?
Zabezpieczyć eksporty, zachować identyfikatory źródłowe, ustalić model podmiot–oddział–kontakt i sprawdzić jakość identyfikatorów podatkowych. Potem utworzyć próbkę do oceny reguł dopasowania. Masowe scalanie powinno być jednym z ostatnich etapów przygotowania danych, nie pierwszym.
Więcej informacji na: https://speimex.pl